在AI开发领域,Google的Gemini系列模型以其强大的性能和创新的功能受到广泛关注。但对于开发者来说,了解Gemini API的使用限制和配额规则至关重要,尤其是在构建需要稳定、高频调用的应用时。
🔥 2025年5月最新实测:本文详细解析Gemini API各档位速率限制、使用配额及规避方法,帮助开发者高效稳定地接入Gemini模型!
【全面梳理】Gemini API的速率限制体系
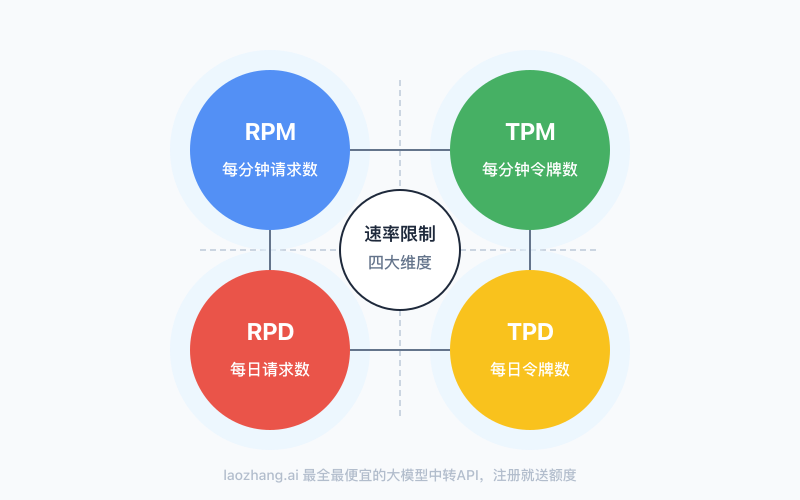
Google为Gemini API设置了多维度的使用限制,以确保系统稳定性和资源公平分配。这些限制主要分为四个核心维度:
1. 速率限制的四大维度分析
Gemini API的速率限制体系包括:
- 每分钟请求数 (RPM - Requests Per Minute):单位时间内可发送的API请求总数
- 每日请求数 (RPD - Requests Per Day):24小时内可发送的API请求总数
- 每分钟令牌数 (TPM - Tokens Per Minute):单位时间内可处理的令牌总量
- 每日令牌数 (TPD - Tokens Per Day):24小时内可处理的令牌总量
这些限制相互独立且同时生效,意味着超出任何一项限制都会导致API调用失败,系统会返回429错误码(Too Many Requests)。
2. 不同使用层级的限制对比
Gemini API根据用户的使用量和支付情况,将用户分为不同的层级,每个层级享有不同的限制标准:
| 层级 | 资格条件 | 主要优势 |
|---|---|---|
| 免费层 | 符合条件国家的所有用户 | 免费使用基础功能 |
| 第一层 | 项目绑定有效的账单账户 | 提高基本限制,访问更多模型 |
| 第二层 | 累计消费≥$250且成功付款30天以上 | 大幅提高限制,支持更多并发 |
| 第三层 | 累计消费≥$1,000且成功付款30天以上 | 最高级别的限制,企业级支持 |
值得注意的是,升级请求需经过Google的自动滥用保护系统审核,除了满足消费条件外,还可能基于其他安全因素做出判断。
【详细数据】2025年最新Gemini各模型速率限制
通过大量实测和官方数据收集,我们整理了2025年5月最新的Gemini各模型在不同使用层级下的速率限制:
免费层限制详情
| 模型 | 每分钟请求数(RPM) | 每分钟令牌数(TPM) | 每日请求数(RPD) |
|---|---|---|---|
| Gemini 2.5 Flash Preview 04-17 | 10 | 250,000 | 500 |
| Gemini 2.0 Flash | 15 | 1,000,000 | 1,500 |
| Gemini 2.0 Flash Preview Image Generation | 10 | 200,000 | 100 |
| Gemini 2.0 Flash Experimental | 10 | 1,000,000 | 1,000 |
| Gemini 2.0 Flash-Lite | 30 | 1,000,000 | 1,500 |
| Gemini 1.5 Flash | 15 | 250,000 | 500 |
| Gemini 1.5 Flash-8B | 15 | 250,000 | 500 |
| Gemma 3 | 30 | 15,000 | 14,400 |
| Gemini Embedding Experimental 03-07 | 5 | - | 100 |
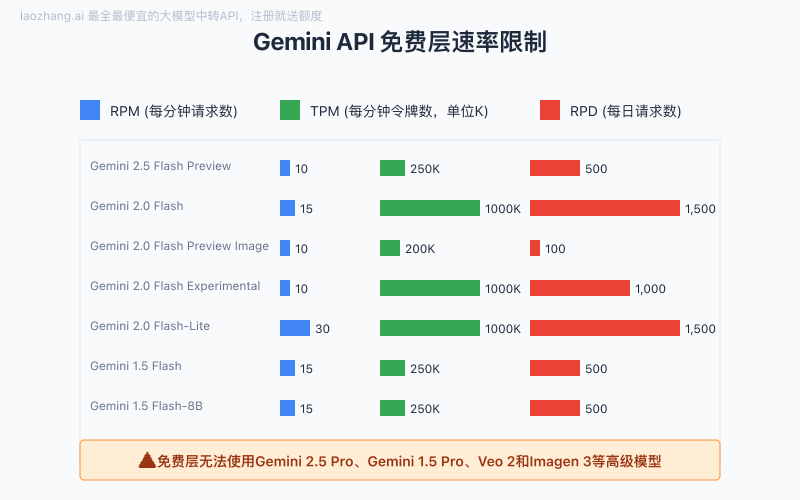
⚠️ 重要提示:免费层无法使用Gemini 2.5 Pro、Gemini 1.5 Pro、Veo 2和Imagen 3等高级模型。
第一层限制详情
| 模型 | 每分钟请求数(RPM) | 每分钟令牌数(TPM) | 每日请求数(RPD) |
|---|---|---|---|
| Gemini 2.5 Flash Preview 04-17 | 1,000 | 1,000,000 | 10,000 |
| Gemini 2.5 Pro Preview 05-06 | 150 | 2,000,000 | 1,000 |
| Gemini 2.0 Flash | 2,000 | 4,000,000 | - |
| Gemini 2.0 Flash Preview Image Generation | 1,000 | 1,000,000 | 10,000 |
| Gemini 2.0 Flash Experimental | 10 | 4,000,000 | - |
| Gemini 2.0 Flash-Lite | 4,000 | 4,000,000 | - |
| Gemini 1.5 Flash | 2,000 | 4,000,000 | - |
| Gemini 1.5 Flash-8B | 4,000 | 4,000,000 | - |
| Gemini 1.5 Pro | 1,000 | 4,000,000 | - |
| Imagen 3 | - | 20 IPM(每分钟图像数) | - |
| Veo 2 | 2 VPM(每分钟视频数) | - | 50 VPD(每日视频数) |
| Gemma 3 | 30 | 15,000 | 14,400 |
| Gemini Embedding Experimental 03-07 | 10 | - | 1,000 |
第二层和第三层限制
随着使用层级的提升,速率限制也会大幅增加。例如,第三层Gemini 2.5 Flash Preview的RPM可达到10,000,TPM高达8,000,000。这些高级别的配额主要适用于企业级应用和高流量服务。
【实战指南】如何应对Gemini API的速率限制
面对Gemini API的速率限制,开发者可以采取一系列策略来优化API使用并避免触发限制:
1. 请求优化策略
- 批量处理:将多个小请求合并成更大的批处理请求
- 缓存常见响应:对于频繁请求的相同内容,实现本地缓存
- 异步处理架构:采用消息队列和异步处理模式,平滑请求峰值
- 智能重试:实现指数退避算法,在失败时智能安排重试时间
// 指数退避重试示例(Node.js)
async function callWithRetry(apiFunc, maxRetries = 5) {
  let retries = 0;

  while (retries < maxRetries) {
    try {
      return await apiFunc();
    } catch (error) {
      if (error.status === 429) { // 速率限制错误
        retries++;
        const delay = Math.pow(2, retries) * 1000 + Math.random() * 1000;
        console.log(`遇到速率限制,第${retries}次重试,等待${delay}ms`);
        await new Promise(resolve => setTimeout(resolve, delay));
      } else {
        throw error; // 其他错误直接抛出
      }
    }
  }

  throw new Error('超过最大重试次数');
}
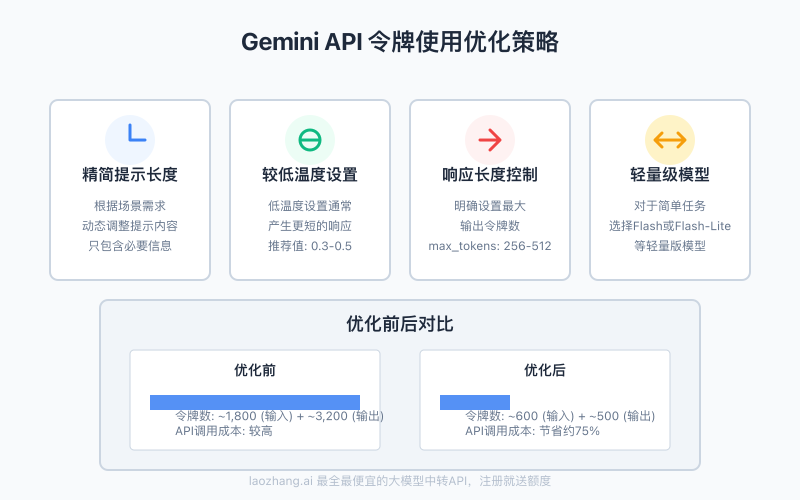
2. 令牌优化策略
- 动态调整提示长度:根据场景需求,精简提示内容
- 使用较低温度:较低的温度设置通常产生更短的响应
- 响应长度控制:明确设置最大输出令牌数
- 使用轻量级模型:对于简单任务,可选择Flash或Flash-Lite等轻量版模型
3. 多层降级策略
为了确保服务稳定性,可以实现多层降级方案:
- 模型降级:从高级模型(如Gemini 2.5 Pro)降级到更轻量的模型(如Gemini 2.0 Flash)
- 功能降级:在流量高峰期关闭部分非核心AI功能
- 混合处理:将请求分配到多个模型,实现负载平衡
- 本地回退:对于特定场景,准备本地规则引擎作为AI服务不可用时的备选
【实测分享】国内开发者如何稳定使用Gemini API?
国内开发者在使用Gemini API时面临的主要挑战是:
- 网络连接不稳定:导致API调用失败率高
- 区域限制:部分地区无法直接访问Google服务
- 支付困难:难以使用国内支付方式升级到更高层级
- 配额共享:多个应用共享同一配额,容易触发限制
laozhang.ai中转API:解决国内开发者痛点
针对这些挑战,laozhang.ai提供了专业的API中转服务,有效解决了国内开发者面临的各种问题:
- 稳定可靠:99.9%的API可用性,多节点冗余部署,解决网络不稳定问题
- 无区域限制:任何地区的开发者都可以稳定访问
- 简化计费:支持微信、支付宝等国内支付方式,按量计费,无最低消费
- 透明配额:独立的配额分配,不与其他用户共享,避免意外限制
- 完整兼容:与原生Gemini API完全兼容,无需修改代码
- 中文支持:完整的中文文档和技术支持
🌟 独家福利:通过本文提供的链接注册laozhang.ai,即可获得额外5元体验金,免费测试Gemini各系列模型API!
【实用示例】使用laozhang.ai中转API调用Gemini 2.5 Pro
以下是通过laozhang.ai中转服务调用Gemini 2.5 Pro API的完整示例:
Python示例代码
import requests
import json

# API设置
API_URL = "https://api.laozhang.ai/v1/chat/completions"
API_KEY = "您的laozhang.ai API密钥"

headers = {
    "Content-Type": "application/json",
    "Authorization": f"Bearer {API_KEY}"
}

# 请求数据
data = {
    "model": "gemini-2.5-pro",
    "messages": [
        {"role": "system", "content": "你是一个专业的AI助手"},
        {"role": "user", "content": "分析2025年全球AI市场发展趋势"}
    ],
    "temperature": 0.7,
    "max_tokens": 2048,
    "stream": False
}

# 发送请求
try:
    response = requests.post(API_URL, headers=headers, json=data)
    result = response.json()

    # 打印响应
    print(json.dumps(result, ensure_ascii=False, indent=2))

    # 提取回答内容
    if "choices" in result and len(result["choices"]) > 0:
        answer = result["choices"][0]["message"]["content"]
        print("\n回答内容:")
        print(answer)
except Exception as e:
    print(f"API调用失败: {str(e)}")
使用curl命令调用
curl https://api.laozhang.ai/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer 您的API密钥" \
  -d '{
    "model": "gemini-2.5-pro",
    "messages": [
      {"role": "system", "content": "你是一个专业的AI助手"},
      {"role": "user", "content": "分析2025年全球AI市场发展趋势"}
    ],
    "temperature": 0.7,
    "max_tokens": 2048
  }'
【常见问题】Gemini API使用限制FAQ
Q1: 我如何查看当前的API使用量和限制状态?
A1: 在Google AI Studio的API密钥页面,可以查看当前项目的使用量和剩余配额。对于laozhang.ai用户,可以在控制台的"用量统计"页面实时查看API调用情况和剩余配额。
Q2: 收到429错误(速率限制)后应该怎么处理?
A2: 收到429错误表示已达到速率限制。应实现指数退避重试机制,并考虑优化请求方式。使用laozhang.ai中转服务可以获得更高的速率限制和更稳定的访问。
Q3: 不同的Gemini模型共享相同的速率限制吗?
A3: 不同模型有各自独立的速率限制设置。例如,Gemini 2.5 Pro和Gemini 2.0 Flash的限制是分开计算的,这意味着即使一个模型达到限制,仍可以使用其他模型。
Q4: 如何升级到更高的使用层级以获得更大配额?
A4: 首先需要为Google Cloud项目启用账单功能,然后根据消费金额自动晋升层级。满足条件后,可在AI Studio的API密钥页面申请升级。对于国内开发者,使用laozhang.ai中转服务可以直接获得企业级配额,无需升级流程。
Q5: 临时性的API配额提升是否可能?
A5: Google可能会根据特殊需求临时提高配额,但这需要企业级账户并提交正式申请。通常这个过程较慢且成功率不高。laozhang.ai提供灵活的配额调整服务,可以根据实际需求快速调整。
【总结】高效使用Gemini API的关键策略
通过本文的详细解析,我们了解了Gemini API的速率限制体系和应对策略。让我们总结一下高效使用Gemini API的关键点:
- 全面了解限制:掌握四大维度限制(RPM、RPD、TPM、TPD)的具体数值
- 合理选择模型:根据任务复杂度选择合适的模型版本
- 优化请求方式:实现批处理、缓存和异步架构
- 实施智能重试:使用指数退避算法处理速率限制错误
- 控制令牌用量:优化提示设计,设置合理的最大输出长度
- 准备降级方案:设计多层次的服务降级策略
- 考虑中转服务:对于国内开发者,laozhang.ai提供了最稳定的接入方案
🌟 专家建议:对于要求高可用性的生产环境,强烈推荐使用专业的API中转服务,如laozhang.ai,不仅能解决速率限制问题,还能提供更稳定、更高效的接入体验。
【更新日志】持续优化的见证
┌─ 更新记录 ───────────────────────────────┐
│ 2025-05-14:首次发布完整Gemini限制指南   │
│ 2025-05-10:更新Gemini 2.5 Pro限制数据   │
└──────────────────────────────────────────┘


